PANTA Whitepaper: Das KI-Label ist nicht das Problem. Schlechter Journalismus schon.
Eine PANTA-Studie mit 360 Teilnehmenden zeigt: Die Kennzeichnung KI-generierter Artikel senkt Akzeptanz nicht automatisch. Entscheidend sind Interesse, Qualität, Kontext und Vertrauen.
Medienhäuser stehen gerade vor einer unangenehmen Entscheidung: Sie können KI im Newsroom nutzen und befürchten, damit Vertrauen zu verspielen. Oder sie können den Einsatz kleinreden – und riskieren Intransparenz, regulatorische Probleme und eine wachsende Schatten-IT.
Hinter dieser Entscheidung steckt oft dieselbe Annahme: Sobald Leserinnen und Leser das Label „KI-generiert“ sehen, sinkt ihre Bereitschaft weiterzulesen. Genau diese Annahme haben wir überprüft. Das Ergebnis ist deutlich weniger dramatisch – und operativ viel hilfreicher.
Nicht das Label entscheidet zuerst über Akzeptanz. Entscheidend ist, ob ein Beitrag relevant, verständlich, glaubwürdig und handwerklich gut ist. Transparenz bleibt wichtig. Aber sie ersetzt keine redaktionelle Qualität.
Kurz gesagt
Die KI-Kennzeichnung hatte innerhalb desselben Themenkontexts keinen signifikanten Haupteffekt auf die Weiterleseabsicht.
Der Themenkontext prägte die Bewertung stärker als die ausgewiesene Urheberschaft.
Interesse war über alle getesteten Beiträge hinweg der stärkste und einzige durchgängig signifikante Treiber.
Seit dem 2. August 2026 macht Artikel 50 des EU AI Act Transparenz in bestimmten Fällen zur operativen Pflicht – inklusive technischer Markierung und nutzerseitiger Offenlegung.
1. Was wir tatsächlich getestet haben
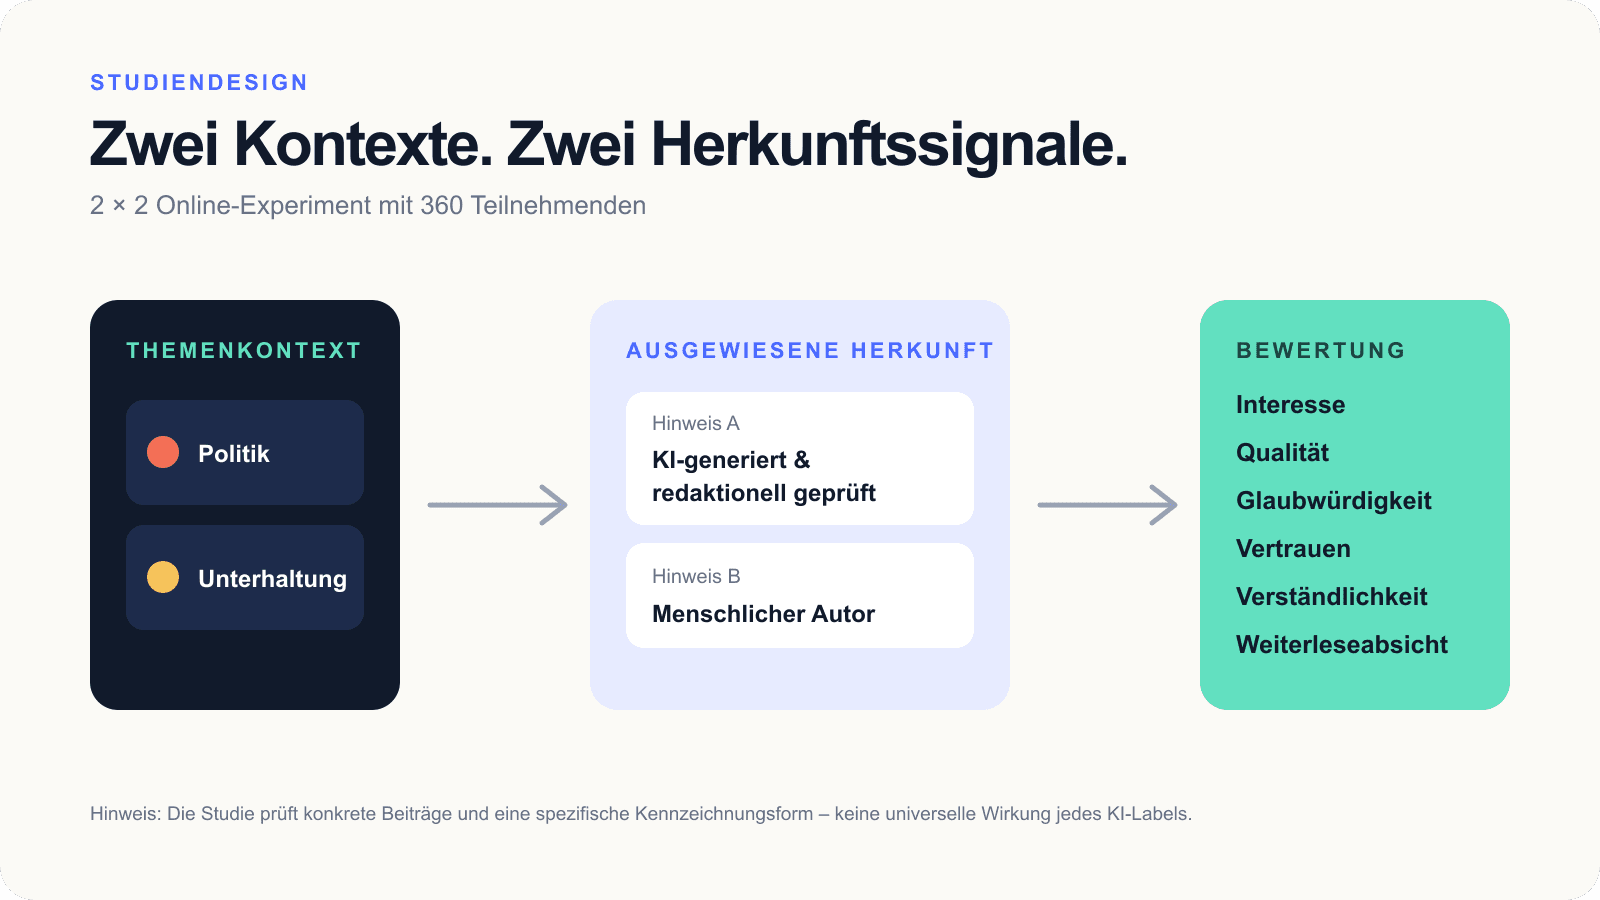
Die Studie war als 2×2-Online-Experiment angelegt. 360 Personen lasen journalistische Beiträge in einem politischen oder unterhaltenden Kontext. Gleichzeitig variierte die ausgewiesene Urheberschaft: einmal „KI-generiert, redaktionell geprüft“, einmal menschlicher Autor.
Anschließend bewerteten die Teilnehmenden unter anderem Interesse, Qualität, Glaubwürdigkeit, Vertrauenswürdigkeit, Verständlichkeit und ihre Bereitschaft, den Artikel weiterzulesen.
Damit ging es nicht um die abstrakte Frage, ob Menschen KI grundsätzlich mögen. Es ging um eine konkrete Nutzungssituation: Was passiert, wenn ein realistisch präsentierter redaktioneller Beitrag sichtbar mit KI entstanden ist?
2. Das Label ist nicht der Akzeptanzkiller
Die zentrale Erkenntnis: Innerhalb desselben Themenkontexts zeigte das KI-Label keinen signifikanten Haupteffekt auf die Weiterleseabsicht. Ein Beitrag wurde also nicht allein deshalb abgelehnt, weil seine KI-Unterstützung transparent ausgewiesen war.
Das ist kein Freifahrtschein für jede Form automatisierter Inhalte. Getestet wurde eine klare Formulierung mit redaktioneller Prüfung. Die Ergebnisse sagen nicht, dass jedes Label, jedes Thema und jede Publikation gleich reagieren. Sie zeigen aber: Die verbreitete Gleichung „KI-Label = Vertrauensverlust“ ist zu simpel.
Für Redaktionen verschiebt sich damit die Frage. Nicht: Wie verstecken wir KI? Sondern: Wie sichern wir sichtbar Qualität, Verantwortung und redaktionelle Kontrolle?
3. Der Inhalt schlägt das Label
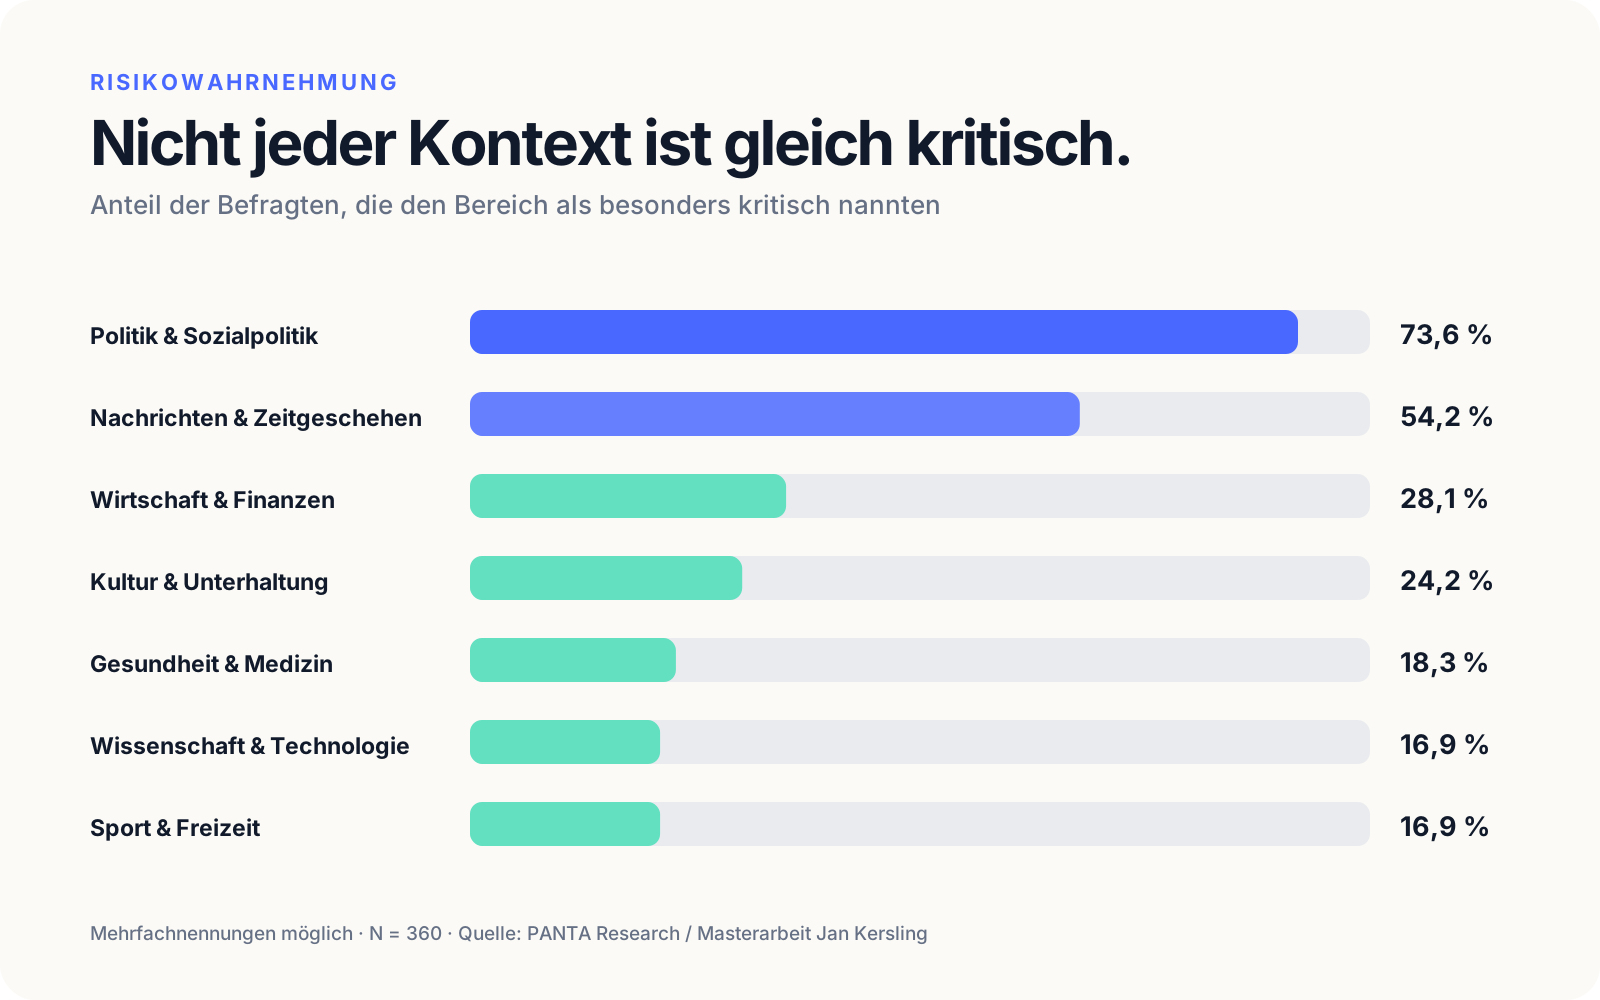
Der Themenkontext beeinflusste die Bewertungen stärker als die Urheberschaft. Besonders politische und gesellschaftliche Inhalte wurden sensibler bewertet als Unterhaltung. Das deckt sich mit der expliziten Wahrnehmung der Befragten: 73,6 Prozent nannten Politik und Sozialpolitik als besonders kritischen Einsatzbereich für KI-generierte journalistische Inhalte. Bei Kultur und Unterhaltung waren es 24,2 Prozent.
Transparenz sollte deshalb nicht als identischer Hinweis über alle Inhalte gelegt werden. Ein Börsenkommentar, eine Wahlprognose und ein Festivalguide tragen unterschiedliche Risiken. Gute Governance beginnt mit dieser Differenzierung.
4. Interesse ist der stärkste Hebel
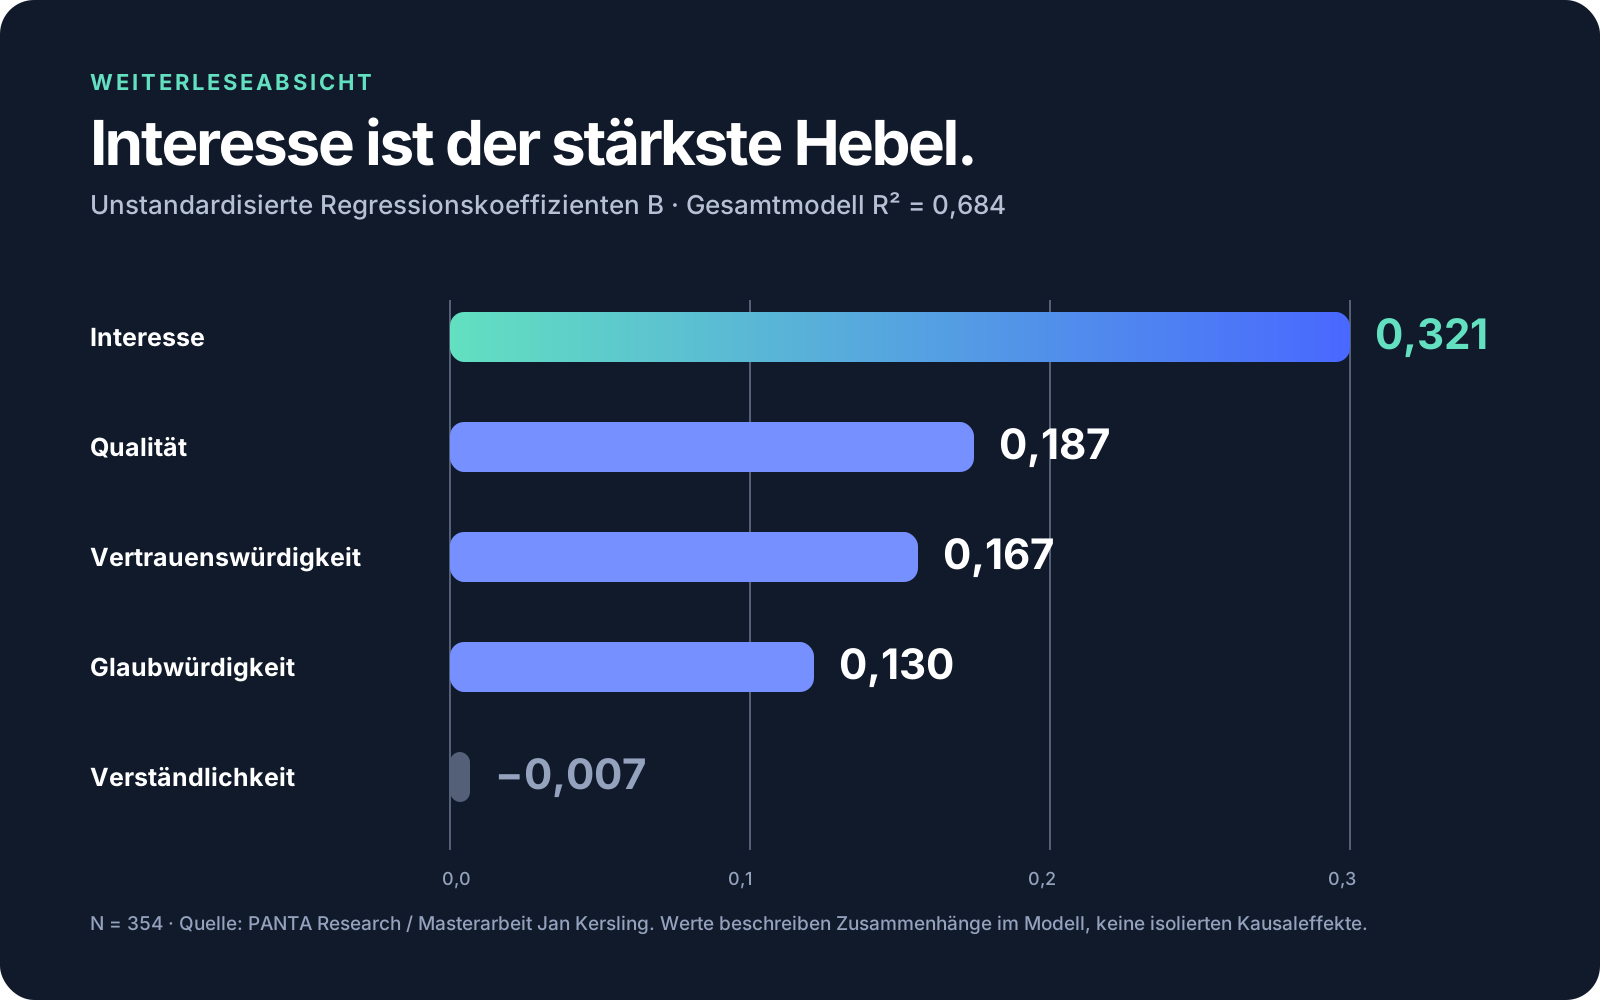
Im Gesamtmodell ließen sich rund 68 Prozent der Unterschiede in der Weiterleseabsicht erklären. Der stärkste Faktor war Interesse. Danach folgten wahrgenommene Qualität, Vertrauenswürdigkeit und Glaubwürdigkeit. Verständlichkeit zeigte – bei gleichzeitiger Betrachtung der anderen Faktoren – praktisch keinen zusätzlichen Beitrag.
Das ist für Content-Teams eine gute Nachricht. Leserinnen und Leser reagieren nicht nur auf Herkunftssignale. Sie reagieren auf den Wert, den ein Beitrag für sie hat. KI kann Recherche, Strukturierung und Produktion beschleunigen. Akzeptanz entsteht aber erst, wenn daraus relevanter Inhalt wird.
5. Zielgruppen sind weniger demografisch, als viele denken
Alter, Geschlecht und andere demografische Merkmale erwiesen sich nicht als dominante, konsistente Moderatoren. Das spricht gegen pauschale Annahmen wie „Jüngere akzeptieren KI ohnehin“ oder „Ältere lehnen sie grundsätzlich ab“.
Sinnvoller ist eine verhaltensnahe Segmentierung: Wie hoch ist das Interesse am Thema? Wie vertraut ist die Person mit KI? Wie kritisch ist der Kontext? Und welche Form von redaktioneller Verantwortung wird sichtbar?
6. Was der EU AI Act seit August 2026 verändert
Seit dem 2. August 2026 gilt Artikel 50 des EU AI Act. Anbieter generativer Systeme müssen synthetische Inhalte grundsätzlich maschinenlesbar kennzeichnen. Wer bestimmte KI-generierte oder manipulierte Inhalte veröffentlicht, muss sie zudem für Menschen offenlegen – etwa Deepfakes oder Texte zu Themen von öffentlichem Interesse.
Für redaktionelle Inhalte ist eine wichtige Ausnahme vorgesehen: Eine zusätzliche Offenlegungspflicht entfällt, wenn eine menschliche Prüfung oder redaktionelle Kontrolle stattgefunden hat und eine natürliche oder juristische Person redaktionelle Verantwortung trägt. Die genaue Einordnung hängt vom konkreten Einsatz ab und ersetzt keine juristische Prüfung.
Operativ laufen damit zwei Ebenen zusammen: technische Herkunftsnachweise und verständliche Kommunikation gegenüber dem Publikum. Ein sichtbares Label allein ist noch kein Compliance-System. Und ein Compliance-System allein erzeugt noch kein Vertrauen.
7. Was Medienhäuser jetzt tun sollten
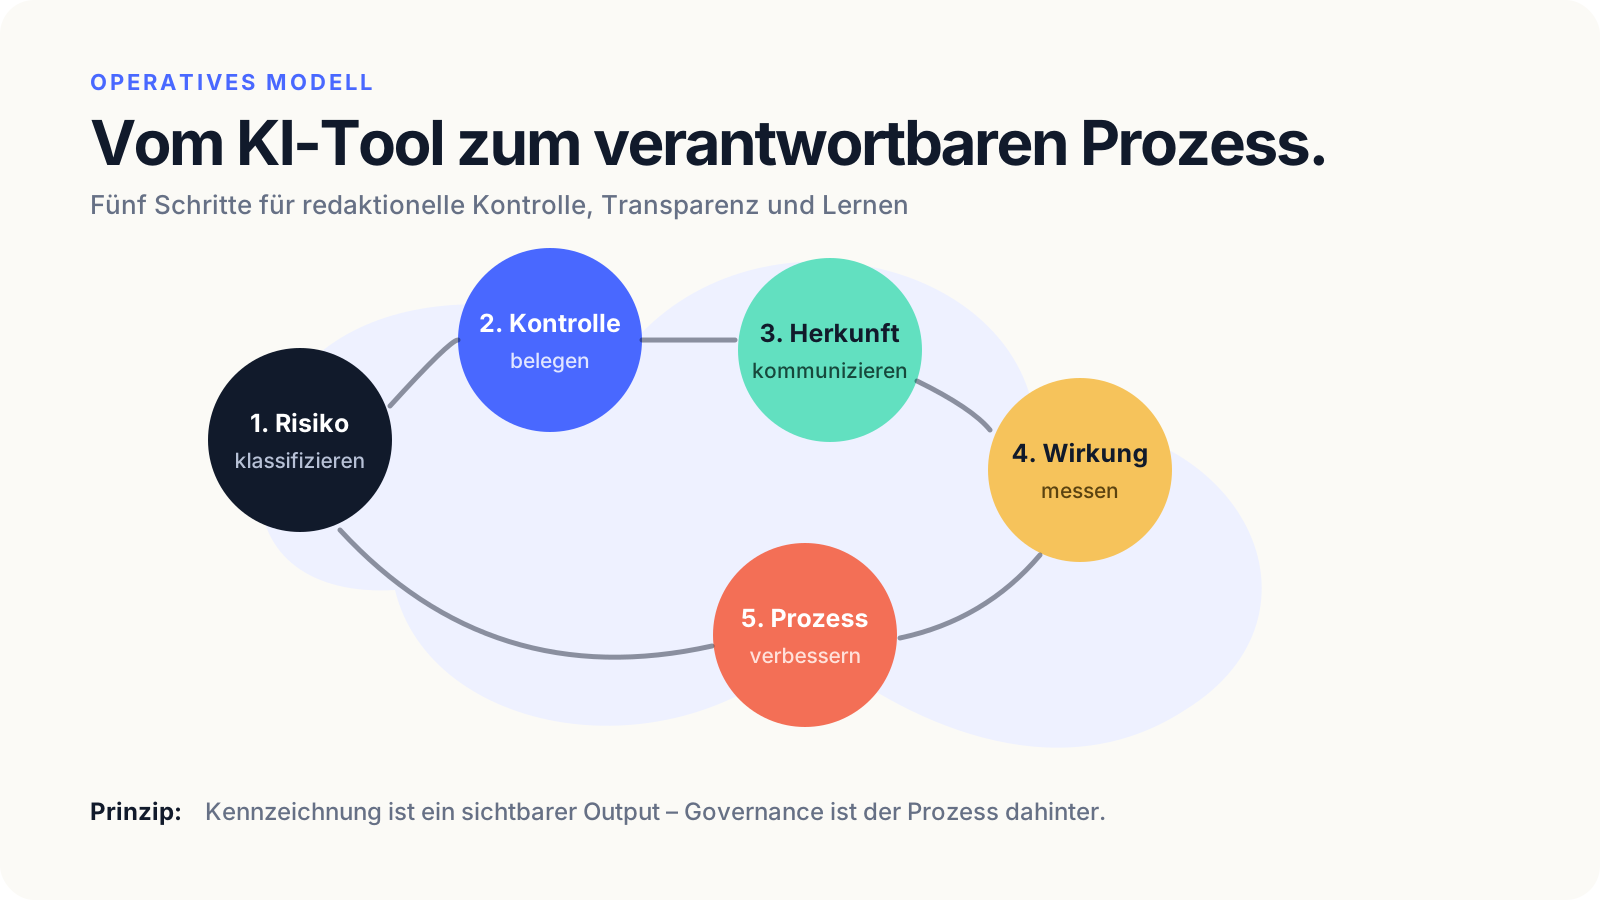
Erstens: Inhalte nach Risiko und Kontext klassifizieren. Politik, Gesundheit und Finanzen brauchen andere Freigaben als Unterhaltung oder Service-Content.
Zweitens: redaktionelle Kontrolle belegbar machen. Wer hat geprüft? Welche Quellen wurden verwendet? Welche Änderungen wurden vorgenommen? Verantwortung muss nicht nur existieren, sondern im Prozess nachweisbar sein.
Drittens: Kennzeichnungen verständlich formulieren. „KI-generiert, redaktionell geprüft“ vermittelt etwas anderes als ein technisch korrektes, aber nichtssagendes Symbol.
Viertens: Akzeptanz messen. Nicht nur Klicks. Auch Interesse, wahrgenommene Qualität, Vertrauen und Abbruchraten zeigen, ob ein KI-gestützter Workflow beim Publikum funktioniert.
Fünftens: aus jedem Einsatz lernen. Templates, Freigaben und Modelle sollten mit realen Ergebnissen verbessert werden – nicht nach Bauchgefühl.
Was wir daraus gelernt haben
Transparenz und Akzeptanz sind kein Widerspruch. Das Label ist selten der stärkste Hebel – und genau deshalb darf es nicht isoliert betrachtet werden. Wer KI im Content-Prozess verantwortungsvoll einsetzen will, braucht relevante Inhalte, klare redaktionelle Zuständigkeit und einen nachvollziehbaren Workflow.
Die bessere Frage lautet also nicht: Akzeptieren Menschen KI-generierte Artikel? Sondern: Unter welchen Bedingungen verdienen KI-gestützte Artikel ihre Aufmerksamkeit und ihr Vertrauen?
Genau dort setzt PANTA an: KI-Nutzung nicht als Einzellösung, sondern als steuerbaren Prozess mit Rollen, Freigaben, Dokumentation und Messpunkten.
Article written by
